01
Auditoría de cobertura de índice
Revisión del informe de cobertura de Search Console para identificar páginas excluidas, con errores o rastreadas sin indexar.


Diagnostico por qué Google no rastrea, no indexa o indexa mal páginas de tu sitio, y corrijo la causa técnica concreta: robots.txt, sitemap XML, etiquetas noindex, crawl budget o señales contradictorias entre canonical e indexación. Sin esta base, ninguna otra mejora de contenido o de enlaces llega a competir.
El rastreo es el proceso por el cual Google descubre y visita las URLs de un sitio, siguiendo enlaces, leyendo el sitemap XML y respetando las reglas del robots.txt. La indexación es el paso siguiente: una vez que Google rastreó una página, decide si la guarda en su índice para poder mostrarla en resultados de búsqueda. Una página puede rastrearse sin llegar a indexarse, y esa distinción es la primera pregunta que hay que responder ante cualquier problema de visibilidad.
Confundir ambos conceptos lleva a diagnósticos equivocados: bloquear el rastreo de una página en robots.txt no la elimina del índice si ya estaba indexada, y una página perfectamente rastreable puede seguir sin indexarse si Google la considera de bajo valor, duplicada o de calidad insuficiente. Cada escenario exige una corrección distinta, y aplicar la solución equivocada puede empeorar el problema.
El servicio general de SEO Técnico cubre indexación, rendimiento, datos estructurados, arquitectura y migraciones como un conjunto. Esta página profundiza específicamente en la capa de rastreo e indexación: si Google puede acceder a tus páginas, decide guardarlas en su índice y las mantiene ahí de forma consistente con lo que publicas.
Es distinta de Auditoría SEO, la landing comercial de auditoría técnica completa: esa página cubre todas las áreas del SEO técnico en un mismo diagnóstico integral, mientras esta solución se contrata quirúrgicamente cuando el problema ya está acotado a indexación y rastreo, o cuando una auditoría previa identificó esa área como prioritaria.
También conviene diferenciarla de Datos Estructurados y Schema dentro de este mismo silo: esa página trabaja cómo Google interpreta y enriquece el contenido ya indexado, mientras esta página trabaja el paso previo, que ese contenido llegue a formar parte del índice.
El diagnóstico combina datos de Search Console con un rastreo técnico independiente del sitio, porque los datos que reporta Google no siempre coinciden con lo que un crawler externo encuentra al recorrer las mismas URLs.
Revisión del informe de cobertura de Search Console para identificar páginas excluidas, con errores o rastreadas sin indexar.
Confirmación de que las reglas de bloqueo de rastreo son intencionales y no están excluyendo por error secciones relevantes del sitio.
Verificación de que el sitemap incluye únicamente URLs indexables y refleja el contenido real del sitio, sin páginas obsoletas o rotas.
En sitios grandes, priorización de qué secciones merecen rastreo frecuente y cuáles deberían consumir menos presupuesto de rastreo.
Revisión cruzada de etiquetas canonical, noindex, hreflang y sitemap para eliminar contradicciones que confunden a Google.
Una vez corregidas las causas, solicitud de rastreo prioritario para las páginas afectadas y seguimiento de su reincorporación al índice.
Search Console clasifica cada URL en un estado concreto de cobertura, y ese estado determina qué corrección aplica. Confundir un estado con otro suele llevar a aplicar la solución equivocada.
| Estado en Search Console | Qué significa | Corrección típica |
|---|---|---|
| Rastreada, actualmente sin indexar | Google visitó la página pero decidió no guardarla en el índice | Revisar calidad, contenido duplicado o valor real de la página |
| Descubierta, actualmente sin indexar | Google conoce la URL pero todavía no la ha rastreado | Revisar crawl budget y prioridad de enlazado interno hacia esa URL |
| Bloqueada por robots.txt | Una regla impide el rastreo de esa URL de forma intencional o por error | Confirmar si el bloqueo es deseado; corregir la regla si fue un error |
| Excluida por etiqueta noindex | La página indica explícitamente que no debe indexarse | Confirmar intención; eliminar la etiqueta si la página debería indexarse |
El trabajo se entrega con un informe de cobertura claro sobre qué páginas están indexadas, cuáles están excluidas y por qué, junto con la evolución del rastreo tras aplicar las correcciones.
Ejemplo ilustrativo. No representa datos reales de ningún proyecto.
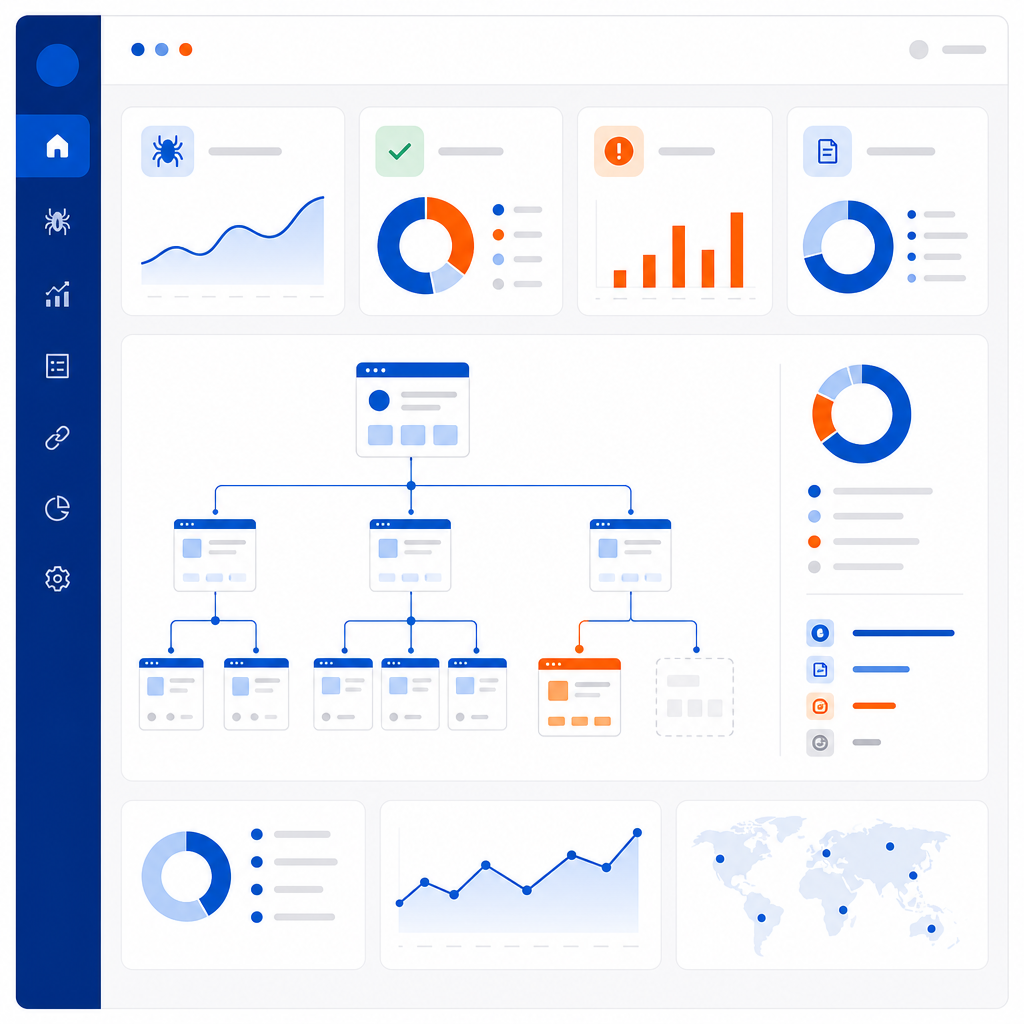
Ejemplo ilustrativo de estadísticas de rastreo y mapa del sitio.
Cada sitio combina un conjunto distinto de causas según su plataforma y su historial técnico. Estos son los escenarios más habituales con los que empieza el diagnóstico.
Reglas de robots.txt heredadas de un entorno de pruebas que siguen bloqueando secciones del sitio en producción.
Un sitemap que incluye URLs eliminadas o excluye páginas nuevas relevantes que Google todavía no descubrió.
En catálogos grandes, Google dedica tiempo de rastreo a páginas de filtros o parámetros mientras ignora contenido importante.
Una página con canonical hacia otra URL pero incluida en el sitemap como si fuera la versión principal.
El diagnóstico combina datos de Search Console, rastreo técnico independiente y, cuando está disponible, revisión de logs del servidor para entender el comportamiento real de los rastreadores de Google.
Cruzo el informe de cobertura de Search Console con un rastreo propio del sitio para detectar discrepancias.
Agrupo cada URL problemática según su estado exacto de indexación para aplicar la corrección correspondiente.
Ajusto robots.txt, sitemap, etiquetas noindex y canonical, coordinando los cambios con quien administra el sitio.
Solicito reindexación y confirmo en las semanas siguientes que la cobertura de índice mejora como se esperaba.
El indicador más directo es la proporción de páginas publicadas que Google realmente indexa: un aumento en esa proporción, sin haber publicado contenido nuevo, confirma que las correcciones técnicas están funcionando. También conviene revisar cuánto tiempo tarda Google en descubrir e indexar contenido nuevo tras las correcciones, comparado con el comportamiento previo.
Una vez que la cobertura de índice mejora, el efecto debería notarse en el resto del embudo: más páginas disponibles para competir en resultados de búsqueda y, con el tiempo, un tráfico orgánico más consistente con el volumen de contenido publicado.
Proporción de páginas publicadas que Google indexa correctamente.
Tiempo que tarda Google en rastrear e indexar contenido nuevo.
Reducción de URLs excluidas por bloqueos o señales contradictorias.
Tráfico orgánico atribuible a páginas que antes estaban fuera del índice.
Indexación y Rastreo forma parte, junto a Core Web Vitals, de las primeras soluciones especializadas publicadas dentro del silo de SEO Técnico. Aquí encuentras el servicio pilar, guías del blog relacionadas con enlazado interno y velocidad, y otras especialidades del sitio.
Respuestas pensadas para quien tiene páginas que no aparecen en Google y necesita entender la causa real antes de intentar corregirla a ciegas.
No hay un plazo fijo. Depende de la frecuencia con la que Google rastrea el sitio en general, de la autoridad del dominio, de si la página está bien enlazada internamente desde contenido que Google ya visita con frecuencia, y de si se envió o no una solicitud de indexación manual a través de Search Console. Sitios con rastreo frecuente pueden ver contenido nuevo indexado en días; sitios con menor autoridad o actividad pueden tardar semanas.
Enviar la URL manualmente a través de la herramienta de inspección de Search Console no garantiza una indexación inmediata, pero suele acelerar el proceso frente a esperar a que Google la descubra por su cuenta. En sitios grandes con muchas páginas nuevas, un sitemap actualizado y un enlazado interno claro son más determinantes a largo plazo que las solicitudes manuales una por una.
El crawl budget es la cantidad de páginas que Google decide rastrear en un sitio durante un periodo de tiempo determinado. En sitios pequeños o medianos rara vez es una limitación real, porque Google puede rastrear todo el contenido sin dificultad. Se vuelve relevante en sitios grandes con miles de URLs generadas por filtros, combinaciones de atributos o contenido generado por usuarios, donde Google puede dedicar tiempo de rastreo a páginas de bajo valor mientras tarda en llegar a contenido importante.
Antes de asumir que el crawl budget es la causa de un problema de indexación, conviene descartar causas más simples y frecuentes: bloqueos en robots.txt, errores de servidor, o señales contradictorias entre canonical y sitemap. El crawl budget suele ser la explicación correcta solo quando esas otras causas ya se descartaron.
Son mecanismos distintos que suelen confundirse. Bloquear una URL en robots.txt impide que Google la rastree, pero si esa página ya estaba indexada antes del bloqueo, puede permanecer en el índice sin que Google pueda leer su contenido actualizado, apareciendo en resultados con información limitada. La etiqueta noindex, en cambio, permite que Google rastree la página pero le indica explícitamente que no debe guardarla en el índice, lo que sí produce su eliminación de los resultados de búsqueda con el tiempo.
Por eso, para eliminar una página del índice de forma efectiva, la etiqueta noindex es la herramienta correcta, no el bloqueo por robots.txt. Combinar ambas al mismo tiempo suele ser contraproducente: si Google no puede rastrear la página por el bloqueo, tampoco puede leer la etiqueta noindex que le indicaría que la retire del índice.
Esta discrepancia es más habitual de lo que parece y suele tener causas identificables: páginas de paginación, filtros o parámetros que se generan automáticamente y que Google indexa aunque no formen parte del conteo que el propietario del sitio tiene en mente; páginas antiguas que siguen indexadas aunque ya no existan o hayan cambiado de URL; o contenido duplicado que Google decidió consolidar bajo una sola versión.
Un rastreo técnico completo del sitio, comparado con el informe de cobertura de Search Console, suele revelar exactamente qué está generando esa diferencia, en lugar de asumir que se trata de un problema genérico de indexación.
No, y es importante entender por qué. Solicitar reindexación le pide a Google que vuelva a rastrear una URL con cierta prioridad, pero no obliga a que la indexe si Google considera que la página tiene problemas de calidad, contenido duplicado o poco valor añadido frente a otras páginas similares. Si la causa raíz del problema de indexación no se corrigió antes de solicitar la reindexación, es probable que Google vuelva a excluir la página del índice tras revisarla de nuevo.
Por eso la solicitud de reindexación debería ser el último paso del proceso, después de haber corregido la causa real detectada en el diagnóstico, y no el primer intento de solución ante cualquier problema de visibilidad.
Puede ser cualquiera de los dos casos, y distinguirlos es parte del diagnóstico inicial. Un bloqueo mal configurado en robots.txt o un error de configuración del servidor puede afectar a secciones completas del sitio de una sola vez. En cambio, problemas de calidad de contenido, canibalización o duplicidad suelen afectar páginas específicas de forma individual, sin que el resto del sitio se vea comprometido.
Revisar si el problema aparece concentrado en una sección concreta del sitio, o distribuido de forma uniforme, ayuda a orientar el diagnóstico hacia una causa técnica generalizada o hacia problemas de contenido específicos de cada página afectada.
Cuéntame sobre tu sitio y revisemos la cobertura de índice actual para identificar exactamente qué está impidiendo que tus páginas aparezcan en resultados de búsqueda.